Пятеро разработчиков, двадцать карточек «в работе», и третий спринт подряд половина задач уезжает в следующий. Первым под подозрение попадает PM. Доска вроде бы это подтверждает. Но чаще неисправность сидит выше человека, который её ведёт.
Scrum, Kanban, backlog и ретроспективы давно лежат в стандартном ящике продуктовой команды, а отдача от них разная. Где-то они ускоряют решения, где-то превращаются в рутину, которую терпят. Расхождение начинается с ожидания, будто правильные ритуалы сами наладят работу.
Инструмент только показывает, как уже устроена работа. Слабое решение он не исправит и стратегию не заменит. Зато по доске видно, где проверять приоритеты, поток задач и то, кто и как принимает решения. Поэтому говорить об Agile-инструментах в отрыве от работы PM и от того, как в компании управляют продуктом, бессмысленно.
Доска показывает среду, а не человека
Когда backlog выглядит как свалка, сроки едут, а команда выгорает, первый рефлекс: найти виноватого. Доска идёт в дело как улика: смотрите, у него всё разваливается.
Рефлекс удобный, но обманчивый. Вся система сводится к одному человеку, и организация как будто ни при чём. Приоритеты чаще скачут из-за давления бизнеса, чем из-за того, что PM не умеет планировать. Если директор по продажам раз в неделю приносит «срочный» запрос крупного клиента, никакой план спринта этого не выдержит. А хаос в backlog обычно значит, что продуктовой стратегии нет вовсе. Agile просто вытащил эти проблемы на свет и создал иллюзию, что виноватый найден.
Проверить это просто. Поменяйте PM мысленно: если новый человек с теми же входящими запросами, тем же составом команды и той же неясной целью получит ту же доску, проблема не в нём.
Сбой случается раньше доски с задачами
Управление продуктом начинается задолго до колонок с карточками. Сначала нужны цели бизнеса, понимание пользователя и правила, по которым задачи ставят в очередь. Доска стоит в самом конце этой цепочки. Если сломано начало, никакие ритуалы это не исправят.
Типичный случай: нет явных критериев успеха. Бизнес хочет роста, команда хочет стабильности, а согласованного ориентира между ними нет. Backlog наполняется задачами разной природы, и инструменты честно фиксируют бесконечный конфликт приоритетов. В самом Scrum для этого есть Product Goal, цель продукта, к которой должен вести каждый элемент списка. Если команда не может назвать свой Product Goal одной фразой, спорить о порядке задач бесполезно: сравнивать их не с чем.
Вторая частая поломка: решают одни, а отвечают другие. Решения принимают где-то вне команды, а за результат спрашивают с неё. Тогда доска перестаёт помогать в управлении и превращается в конвейер, который просто доставляет чужие решения.
Ошибка в гипотезе нормальна, повтор ошибки уже нет
Agile с самого начала исходит из того, что неопределённость неустранима. Ошибки в гипотезах, оценках и приоритетах он считает рабочим материалом, и смысл инструментов в том, чтобы ловить их рано и дёшево.
Нормальная ошибка чему-то учит. Команда проверила гипотезу, получила отрицательный результат и поменяла подход. Так она купила знание о продукте. Плохой знак выглядит иначе: задачи раз за разом не приносят пользы, решения принимают по старым шаблонам, и ничего не меняется. Это уже застой в управлении, и лечат его по-другому.
Некомпетентность тоже видна, но не по одному срыву. Её выдаёт привычка не замечать сигналы: метрики никто не читает, после ретроспектив ничего не меняется, backlog растёт без всякой логики. Второй признак: за процессом прячутся от ответственности. Фразы «так требует Scrum» и «это по Kanban» часто значат одно: никто не хочет рисковать и решать сам.
Полезное правило различения: если один и тот же пункт всплывает на трёх ретроспективах подряд и ни разу не превратился в действие с владельцем и сроком, это уже не ошибка обучения. Это решение ничего не менять, просто никто его вслух не принимал.
Три места, где симптомы всплывают первыми
В повседневной работе проблемы всплывают в исследованиях, в поставке и в коммуникации. Симптомы довольно универсальны и встречаются в командах любого размера.
В исследованиях всё начинается с формальности. Интервью проводят, но их результаты не доходят до backlog. Гипотезы вслух не формулируются, решения принимаются на интуиции. Хуже того, исследование нередко ведётся ради подтверждения уже принятого решения. Исследование как бы есть, но свою работу, снижать неопределённость, оно не делает. Симптом легко проверить: возьмите десять последних задач в backlog и посчитайте, у скольких в описании есть ссылка на интервью, данные или проверенную гипотезу. Ноль из десяти говорит об исследованиях больше любого отчёта.
В поставке картина выглядит как хроническое несоблюдение планов. Спринты перегружены, задачи переезжают, команда не понимает, что действительно важно. Рядом идёт разрыв между задачами и ценностью: работа кипит, а связать сделанное с результатом для пользователя никто не берётся. Поставка превращается в производство активности.
В коммуникации всё упирается в защитную позицию PM. Вопросы команды читаются как давление, обсуждение приоритетов сваливается в спор. Отсюда самый опасный симптом: для разных аудиторий существуют разные версии реальности. Наверх идёт «всё по плану», внутри команды «всё горит». Инструмент перестаёт быть общим языком и становится поводом для недоверия.
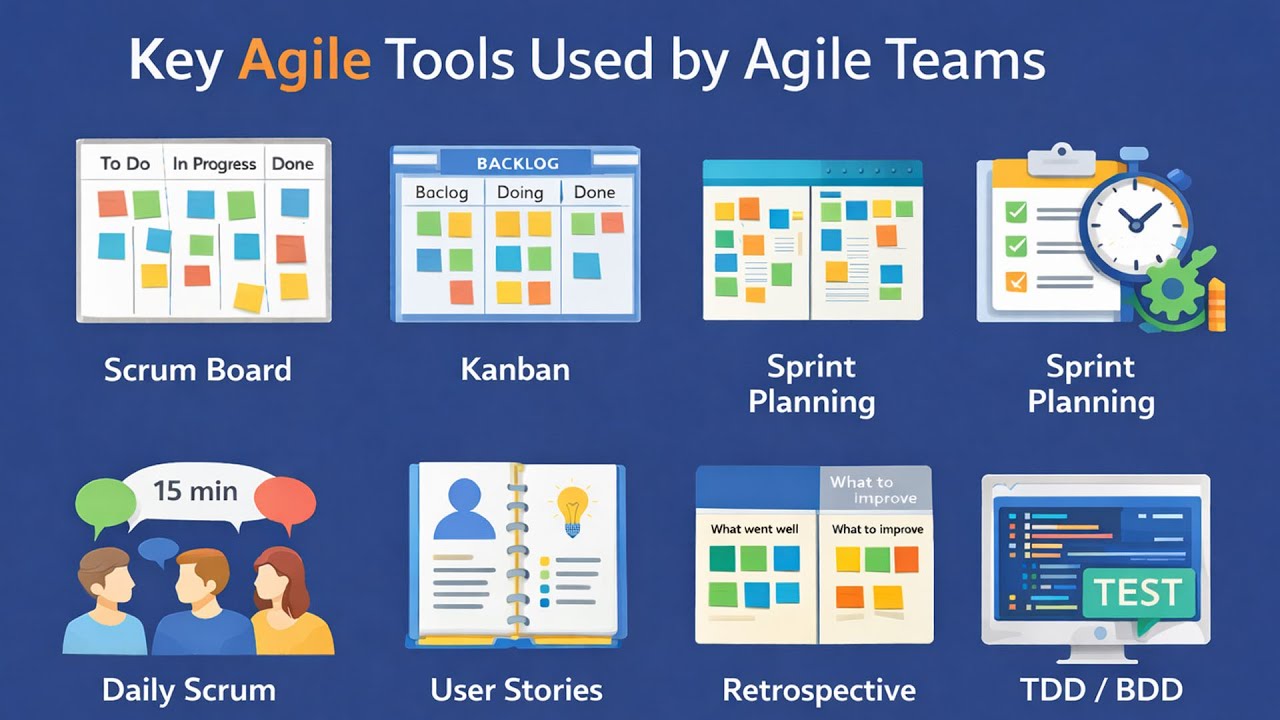
Backlog выдаёт зрелость раньше метрик
Зрелость команды видна по её рабочим документам раньше, чем по графикам. В хорошем backlog видна продуктовая логика: понятно, какую проблему решает каждая строка и почему её взяли именно сейчас. Такой backlog можно отдать новичку, и он поймёт по нему стратегию продукта.
Незрелость выдаёт себя обратным перекосом: ритуалов больше, чем содержания. Митинги идут по расписанию, документы пишутся ради отчёта, решений на выходе нет. Посчитайте время. Если в двухнедельном спринте на планирование, ежедневные встречи, обзор и ретроспективу уходит около 8 часов на человека, это 10% рабочего времени. Окупается оно только тогда, когда хотя бы одна из этих встреч меняет выбор задач. Иначе это налог без возврата.
Одной итерации для диагноза мало, разница проступает через несколько. Зрелая команда пользуется Agile для синхронизации и обучения: каждый цикл что-то меняет в том, как она выбирает задачи. Незрелая превращает тот же Agile в бюрократический фильтр, и её доска через три спринта выглядит так же, как в первый.
Ритуал вместо работы начинается с фразы
Формальный Agile редко выдаёт себя одним симптомом. Признаки тянут друг друга по цепочке, и полезнее видеть цепочку, чем отдельные звенья.
Всё начинается с того, что у продукта нет цели. Без цели backlog становится просто списком дел, а выбор задач сводится к разбору входящих просьб. Из чего тогда выводить гипотезы и критерии успеха? Не из чего. Поэтому данные и отзывы пользователей ничего не решают. О приоритетах спорят на уровне мнений, а мнения меняются быстрее планов. Приоритеты прыгают без объяснений, и вместо стратегии остаётся список задач.
Дальше страдают люди. Никто не понимает, как принимаются решения, поэтому тяжёлые разговоры с заказчиками откладывают. Напряжение копится и прорывается на ретроспективах. А ретроспективы ничего не дают: менять пришлось бы то, о чём не договорились раньше.
Эту цепочку часто слышно раньше, чем видно на доске. «Сейчас не до исследований», «потом оптимизируем»: по отдельности такие фразы звучат разумно. Вместе они портят решения, и доска потом показывает бесконечные переделки. Опаснее всего фраза «так попросили сверху». С ней PM уже не управляет продуктом, а только передаёт задачи, и доска будто узаконивает чужой выбор. Так жила первая из двух команд, о которых пойдёт речь ниже.
Цели на 2 недели и 20 карточек на пятерых
Оба сценария ниже типичны, и в обоих инструменты работали честно, сломано было то, что вокруг них.
Scrum, который срывался каждые две недели
Первая команда пользовалась Scrum формально. Спринты планировали, но они почти всегда срывались. PM обвиняли в плохом планировании, команда жаловалась на хаос.
Разбор показал другое: цели продукта менялись каждые две недели, решения принимались вне команды, backlog переписывался заново. Инструменты фиксировали нестабильность входящего потока, а сам поток чинить никто не пытался. Двухнедельный спринт при целях, которые живут те же две недели, обречён: к обзору спринта команда показывает результат под цель, которой уже нет.
Сделали две вещи: зафиксировали квартальные цели и связали их с критериями приоритизации, а PM получил мандат защищать фокус спринта. Мандат был конкретным: срочная задача попадает в текущий спринт только в обмен на равную по объёму, и решение о такой замене принимает PM вместе с заказчиком задачи. Поток экстренных задач сократился. Через несколько месяцев спринты стали предсказуемыми, команда снова увидела смысл в планировании. Инструменты остались прежними, поменялась система вокруг них.
Перегруженная доска Kanban без WIP-лимитов
Во втором кейсе был Kanban, но доска стояла забитая. WIP-лимиты игнорировали, задачи висели неделями, и PM решил, что инструмент их продукту не подходит.
Диагностика оказалась банальной: все задачи считались одинаково срочными, деления по типам работ и по ценности не было. Когда в колонке «в работе» два десятка карточек на команду из пяти человек, каждая ползёт медленно: люди переключаются, и ни одна не доходит до конца быстро. Kanban честно показывал перегрузку, но выводов из этого не делали.
Разделили поток, ввели явные правила приоритизации, и картина изменилась. WIP-лимиты стали осмысленными, время выполнения сократилось.
Почему перегруженная доска буквально замедляет поток, видно из простого соотношения теории очередей. Оно работает везде, где есть поток задач:
Время цикла = Незавершённая работа (WIP) ÷ Пропускная способность
Пропускной способностью здесь называется то, сколько задач команда реально закрывает за единицу времени. По цифрам второго сценария: 20 карточек «в работе» при темпе 5 задач в неделю дают время цикла 20 ÷ 5 = 4 недели на задачу. Ввели WIP-лимит и оставили 5 карточек, и время цикла падает до 5 ÷ 5 = 1 недели, хотя ни людей, ни их скорость не меняли.
На деле выигрыш обычно больше арифметического. Каждое переключение между задачами стоит времени на возврат в контекст, поэтому при 20 карточках темп редко держится даже на 5 задачах в неделю. Допустим, он падает до 4: тогда время цикла уже 20 ÷ 4 = 5 недель. Границы у формулы тоже есть: она описывает средние значения на устойчивом потоке. Если команда за месяц приняла вдвое больше задач, чем закрыла, считать время цикла по формуле рано, сначала надо остановить рост очереди.
Может, это просто плохой PM?
Справедливо возразить, что слабые PM существуют, и иногда доска показывает именно их. Сам довод звучит так: система целей у компании одна, а команды под ней работают по-разному. Если из шести команд с одним директором и одними квартальными целями срывается только одна, валить всё на систему значит прикрывать человека.
Довод верный, и он подсказывает способ проверки. Сравните команды внутри одной системы. Если перенос задач высокий у всех шести, причина в системе: в целях, в потоке запросов, в распределении полномочий. Если он высокий у одной, а у пяти соседей стабилен, разговор о компетенциях конкретного PM уместен. Но и тогда цифра одна ничего не доказывает: при малом числе спринтов разница между командами может оказаться случайной, поэтому сравнивают хотя бы три спринта подряд. И даже тогда стоит проверить, одинаковый ли у команд входящий поток: команда, к которой продажи приходят напрямую, живёт в другой системе, чем команда за платформенным API.
Есть и обратная ловушка. Сильный PM способен месяцами маскировать системную поломку ценой переработок, и метрики команды выглядят прилично, пока он не уйдёт. Поэтому рядом с цифрами стоит оценивать, сколько ручного труда уходит на их поддержание.
Быстрая самопроверка
Чем больше пунктов вызывает заминку, тем формальнее у вас работают инструменты.
- Есть ли у продукта чёткая цель и понимает ли команда, зачем делается каждая задача.
- Связаны ли гипотезы с метриками и используется ли пользовательский фидбек.
- Стабильны ли приоритеты внутри итерации и есть ли критерии успеха.
- Выделено ли время на исследования.
- Приводят ли ретроспективы к изменениям.
- Прозрачны ли решения PM и есть ли единый язык со стейкхолдерами.
- Осознанно ли ограничивается WIP.
- Не подменяется ли стратегия тактикой и измеряется ли ценность наряду с объёмом.
- Понятно ли, что не делается и почему.
- Улучшается ли система со временем, и не служат ли инструменты оправданием.
Спорные ситуации: конфликты, адаптация, метрики
Прозрачность сначала обостряет конфликты
Agile делает работу прозрачной, а прозрачность обостряет то, что раньше тлело незаметно. Стало видно, кто принимает решения, кто задерживает задачи, где теряется ценность, и напряжение вышло наружу. Со стороны это читается как ухудшение атмосферы, хотя проблемы жили в команде и до всякой доски.
Добавляет остроты разная зрелость участников. Один готов открыто разбирать ошибки, другой воспринимает разбор как угрозу. Agile держится на психологической безопасности; без неё прозрачность оборачивается стрессом. Если за конфликтом не следуют управленческие решения, команда начинает винить инструмент, хотя корень в том, что роли и ответственность не проговорены.
Набор ритуалов подбирают под поток работы
Адаптация нужна почти всегда. Команды различаются контекстом, зрелостью, типом продукта, и копирование чужих практик без оглядки на свою реальность даёт формализм. Одной команде подойдёт строгий Scrum, другой ближе гибридный Kanban. Грубый ориентир: если работа приходит предсказуемыми порциями и её можно планировать на две недели вперёд, Scrum садится естественно; если больше трети задач появляется посреди итерации (поддержка, инциденты, интеграции), честнее работать потоком с WIP-лимитами.
Адаптировать значит выбрать те инструменты и встречи, которые помогают принимать решения, и не потерять сами принципы. Менять правила нужно осознанно: стихийные перемены только добавляют хаоса. Правила можно менять, но за каждое кто-то должен отвечать.
Без роли PM можно, без функции управления нельзя
Agile может работать без должности PM. Без самой работы по управлению продуктом не может. Кто-то всё равно должен отвечать за приоритеты, пользу и фокус. Если эту работу размазать по команде, инструментам не на что опереться. Появляется иллюзия самоуправления: решают все вместе, а не отвечает никто. Сильный PM связывает то, что видно на доске, с решениями и не даёт команде сбиться с курса.
С фреймворками похожая история. Agile шире Scrum и Kanban: прозрачность, итеративность и обратную связь можно реализовать по-разному, и некоторые команды живут по собственным процессам, сохраняя Agile-логику. Но уход от известных фреймворков требует высокой зрелости. Без неё легко скатиться в хаос под вывеской гибкости.
Если инструменты тормозят, начинают с решений
Первым делом перестаньте чинить инструменты и посмотрите на решения. Какие допущения стоят за процессами? Какие цели и стимулы движут людьми?
Инструменты кажутся тормозом, когда от них нет толку: время уходит на встречи и документы, а лучше не становится. Обычно новые ритуалы просто добавили поверх старых процессов и ничего не убрали. Нагрузка выросла, пользы нет. Оставьте только те встречи, что меняют решения. Если после встречи за месяц не поменялся ни один приоритет, её можно отменить. Потом честно распределите ответственность: кто решает, кто отвечает за результат и что делать с сигналами с доски. Без этого любые правки останутся косметикой.
Начинать стоит с трёх договорённостей
Выбор фреймворка подождёт. Сначала договоритесь о трёх вещах: какая у продукта цель на ближайший квартал, кто принимает решения о приоритетах и по каким признакам понятно, что задача принесла ценность. Пока этих договорённостей нет, любой Scrum или Kanban ляжет на пустоту и выродится в отчётность. Когда они есть, хватает минимума (одной доски, коротких итераций и честной ретроспективы), а остальное добавляется по мере того, как команда упирается в конкретные ограничения.
Метрики, по которым видна системная причина
Смотрите, насколько ровно идёт работа и что происходит с задачами после «готово». Тревожные признаки такие: скорость команды (velocity) скачет от спринта к спринту, задачи регулярно переезжают в следующий спринт (spillover), путь задачи от старта до релиза становится всё длиннее, многое возвращают на доработку. Обычно это значит, что поток запросов нестабилен, а критерии «готово» размыты. Если состав команды не меняется, а цифры прыгают, проблема почти наверняка в целях и приоритетах.
Для поставки есть проверенный набор из четырёх метрик: как часто выходят релизы, сколько времени проходит от готового кода до продакшена, какая доля изменений приводит к сбою и как быстро систему поднимают после сбоя. Эти цифры описывают всю поставку целиком, поэтому хорошо помогают в споре «виновата система или PM».
Порог удобно задать числом. Допустим, команда берёт в спринт 30 задач и три спринта подряд переносит 9, 11 и 10, то есть около трети. Если за те же шесть недель цель спринта менялась посреди итерации хотя бы дважды, начинайте с потока запросов и полномочий. Если цель стояла, а перенос всё равно выше 20%, разбирайте оценку и декомпозицию задач вместе с PM. Порог в 20% здесь настраиваемый, но записать его заранее полезно: тогда спор идёт о цифре и не переходит на людей.
Ни одна из этих метрик не оценивает PM напрямую: они показывают последствия решений. Velocity к тому же быстро портится, если её делают целью: команда начинает дробить задачи и завышать оценки, и показатель растёт без роста ценности. Интерпретация последствий и реакция на них остаются зоной ответственности PM и организации.
Одни и те же Scrum и Kanban в одной команде выглядят бюрократией, а в другой становятся рычагом роста. Там, где инструменты работают, их сигналы читают и по ним действуют. Там, где Agile буксует, о целях и ответственности так и не поговорили честно, и начинать стоит с этого разговора: одна встреча, одна цель на квартал, одно имя напротив решения о приоритетах.