A/B-тест выглядит как простой и надёжный способ принимать решения: две версии, данные, цифры, а значит, объективно. Эта кажущаяся простота и делает его опасным. Чем проще инструмент на вид, тем чаще им пользуются, не понимая логики, и тем легче принять шум за сигнал.
На практике многие A/B-тесты не приносят продукту ценности. Они либо подтверждают заранее принятое решение, либо создают иллюзию прогресса красивыми процентами в отчёте.
И дело не только в дисциплине команды. Даже хорошо продуманная правка часто оставляет метрику на месте или слегка её портит: поведение людей сложнее любой гипотезы о нём, а сильные эффекты в зрелом продукте давно собраны. Отсюда следует спокойное отношение к нулевому или отрицательному результату: команда не провалилась, она получила обычный для экспериментов исход, ради которого тесты и проводят.
Вопрос «чему мы научились и какое решение приняли» остаётся без ответа, когда нарушена логика эксперимента. А держится она на простой цепочке: бизнес-вопрос, гипотеза, изменение, измерение, решение. Стоит выпасть одному звену, и данные начинают вводить в заблуждение.
Тест как подтверждение уже принятого решения
Когда тесты не дают роста, первым винят того, кто их запускает: не те гипотезы, не так тестирует, не умеет работать с данными. Такое объяснение удобно: виноват один человек. Но эксперименты живут не сами по себе. Часто компания ждёт от них подтверждения своих идей, и новое знание её интересует меньше. Тесты запускают для отчёта, чтобы показать активность или защитить уже принятое решение перед руководством.
В такой системе личная компетентность не спасает: продакт-менеджер может идеально знать статистику, но если данные не используются для решений, он неизбежно выглядит неэффективным.
Цепочка: от вопроса бизнеса до решения
Всё начинается раньше идеи и раньше правки интерфейса. Начало: вопрос, на который бизнес не знает ответа. Например, почему пользователи не доходят до главного действия или что мешает им вернуться. Этот вопрос превращают в гипотезу, которую можно проверить: догадку о причине поведения и о том, что должно измениться. Если гипотеза не связана с вопросом, эксперимент бессмыслен с самого начала.
Чаще всего цепочка рвётся на последнем шаге, на решении. Тест прошёл, данные есть, но решение либо не принимают, либо принимают независимо от результата. С этого момента A/B-тесты становятся фоновым шумом: команда что-то запускает, что-то измеряет, но ничего не меняет.
Неудачный тест и плохой тест: где граница
Ошибки в тестировании неизбежны: любая гипотеза остаётся предположением о поведении людей, а оно редко укладывается в простые модели. Ошибка в ожидании эффекта нормальна: команда ждала роста метрики, получила ноль, и это полезный исход, если он уменьшил неопределённость и помог отказаться от слабой идеи. Нормальна и ошибка в силе изменения: иногда правка не влияет на поведение, потому что слишком слабая или не задевает реальную мотивацию, и такой результат ценен, если зафиксирован и осмыслен.
Ошибка становится некомпетентностью, когда команда не учится. Если одни и те же типы тестов запускают снова и снова, а выводы не меняются, данные используются формально. Тот же диагноз ставят подгонке результатов: тест останавливают при первом удобном значении или меняют метрики по ходу, и данные перестают быть источником знания. Показательнее всего ситуация, когда результат эксперимента в принципе не может изменить план действий; такой тест не стоило запускать.
Поиск решений, разработка и споры о цифрах
Пока команда ищет, что делать (discovery), A/B-тесты часто запускают вместо того, чтобы понять проблему. Решения тестируют сразу, не разобравшись, почему люди ведут себя именно так, и гипотезы выходят поверхностными. Тогда любой результат легко повернуть в свою пользу: рост подтверждает идею, падение списывают на внешние причины. Правильно, когда тест проверяет конкретную догадку о выборе пользователя. Тогда команда узнаёт новое при любом исходе.
Когда продукт уже делают (delivery), тесты мешают срокам. Решение уже запланировано, а эксперимент нужен для галочки, поэтому его заканчивают раньше времени или не смотрят на результат. Снаружи это похоже на работу по данным, но доверие к данным пропадает: команда привыкает, что тесты ничего не решают. В зрелой команде результат теста может сдвинуть план релиза, и поэтому его ждут.
В общении проблемы видны по спорам о цифрах. Разные команды читают одни и те же данные по-разному и используют их как аргумент. Если заранее не договориться, как читать результат, данные становятся способом манипуляции: каждый находит срез, который подтверждает его правоту. В зрелой команде места для этого меньше, потому что правила записаны до запуска.
Формулу эксперимента записывают до запуска
Зрелость видна по тому, с чего начинается тест. В зрелой команде, ещё до настройки варианта, записывают, зачем нужен эксперимент и какое решение от него зависит. Первый документ и есть та самая формула: вопрос бизнеса, гипотеза, изменение, метрика, решение. Статистики в ней нет, она о ходе мысли. Без любого элемента эксперимент теряет смысл: цепочка от вопроса к решению рвётся как раз в пропущенном звене.
Во втором документе, карточке теста, до запуска записывают гипотезу, ожидаемый эффект, главную метрику, дополнительные и защитные метрики, группы пользователей и условия остановки. Она не даёт задним числом переписать выводы под удобный результат. Незрелость видна там, где таких документов нет или они для галочки. Тесты запускают «на словах», гипотезы уточняют по ходу, решения принимают без оглядки на данные, и данные почти всегда служат самообману.
Где тест превращается в бесполезный
Большинство пустых экспериментов сводится к нескольким механизмам. Нет бизнес-вопроса, и тест не поддерживает никакого решения. Гипотеза описана как идея, без ожидаемого поведения пользователя. Метрику выбрали потому, что её легко посчитать, хотя на бизнес она почти не влияет. Нет критериев решения, и команда не знает, что делать при разных исходах.
Смотрят на одну цифру, игнорируя побочные эффекты. Наконец, тестируют ради активности: число экспериментов становится важнее качества решений.
На планёрках их легко узнать по фразам: «давайте просто попробуем, вдруг сработает», «если значимо, значит правильно», «результат странный, давайте его не учитывать», «метрику можно поменять, так будет понятнее». За каждой такой репликой данные служат оправданием, узнать из них уже ничего нельзя.
Что значимость показывает, а что нет
Статистическая значимость отвечает лишь на один вопрос: как часто такая разница возникала бы случайно, если бы варианты на деле не отличались. Она ничего не говорит о размере эффекта и о его ценности для бизнеса. Значимый прирост в доли процента на метрике, которую команда не способна сдвинуть дальше, не стоит внедрения; заметный эффект на маленькой выборке может оказаться шумом. Поэтому значимость читают вместе с размером эффекта и защитной метрикой: выигрыш в основном показателе не должен достигаться ценой проседания удержания или выручки.
Отдельная ловушка называется подглядыванием (peeking): если останавливать тест в момент, когда цифры «случайно» стали хорошими, значимость перестаёт что-либо гарантировать, и именно поэтому критерий остановки фиксируют заранее.
Масштаб этой ловушки измерен. В работе Джохари, Пекелиса и Уолша «Peeking at A/B Tests» (2017) показано, что многократные промежуточные проверки классического теста поднимают долю ложных срабатываний в разы выше заявленных 5%. У проблемы есть два решения. Первое, дисциплинарное: зафиксировать размер выборки и смотреть на результат один раз, в конце. Второе, методическое: использовать методы последовательного анализа и «always-valid» интервалов, которые специально позволяют подглядывать безопасно и встроены, например, в статистический движок Optimizely. Выбирать между ними нужно осознанно, но нельзя брать худшее от обоих: смотреть на классический тест каждый день и трактовать результат так, будто выборка была зафиксирована.
Почему прирост читают вместе с размером выборки
Пусть в контроле конверсия 4,0%, а в варианте 4,6%.
- Абсолютный прирост: 4,6% минус 4,0% = 0,6 п.п.
- Относительный прирост: 0,6 / 4,0 = +15%
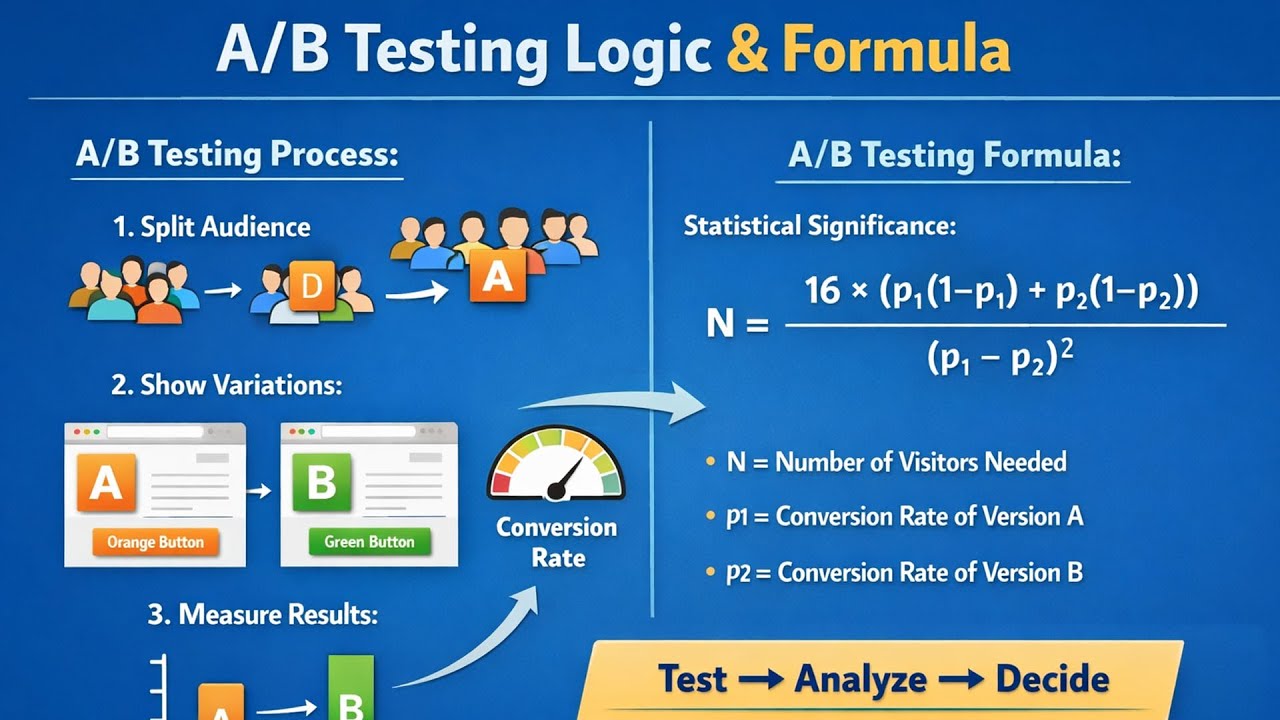
Сам по себе прирост ещё ничего не доказывает: вопрос в том, хватает ли выборки, чтобы отличить его от шума. Грубую оценку нужного размера выборки на каждый вариант (уровень значимости 5%, мощность 80%) даёт n ≈ 16 × p × (1-p) / MDE², где p означает базовую конверсию, а MDE минимальный абсолютный эффект, который вы хотите различить. Для нашего случая:
n ≈ 16 × 0,04 × 0,96 / 0,006² ≈ 17 000 на вариант.
Тот же наблюдаемый прирост на тысяче пользователей и на двадцати тысячах значит совсем разное. Поэтому после теста считают доверительный интервал эффекта: то, что группа добрала плановый размер, само по себе результат не доказывает. Отсюда практическое правило: MDE и размер выборки фиксируют до старта, иначе «значимый» результат окажется просто ранней остановкой на удачном срезе.
Меньше тестов, больше решений
Возьмём две типичные команды без имён. Команда мобильного приложения запускала A/B-тесты почти каждую неделю, отчёты регулярно показывали локальные улучшения, но главная бизнес-метрика не росла. Продакт-менеджер был под давлением: формально тестирование шло активно, результата не было. Анализ показал, что тесты не связаны с конкретными решениями: формула эксперимента отсутствовала, были изменения и метрики, но не было чёткого вопроса.
Ввели простое правило: ни один тест не запускается без сформулированного бизнес-вопроса и заранее описанного решения. Это резко сократило число экспериментов, зато каждый стал осмысленным. Часть тестов показала, что популярные идеи не работают, и от них отказались. Через несколько месяцев главная метрика выросла, хотя экспериментов стало меньше: сработали решения, принятые по их итогам.
В SaaS-продукте A/B-тесты использовали как аргумент в спорах: команды запускали эксперименты, чтобы доказать свою правоту, и один и тот же результат толковали по-разному. Продакт-менеджер оказался арбитром без правил: он отвечал за тесты, но не мог навязать единую логику анализа.
Решением стала обязательная формула эксперимента: бизнес-вопрос, гипотеза и решение фиксировали до запуска. Гибкость интерпретации снизилась, зато доверие к данным выросло, а споров стало меньше: пространство для манипуляций сузилось. A/B-тестирование перестало быть оружием в дискуссиях и стало инструментом обучения.
Четыре вопроса до запуска
Есть ли у теста бизнес-вопрос и зафиксирована ли гипотеза до запуска? Выбраны ли заранее ключевая и защитная метрики и критерий остановки? Может ли результат реально изменить планы? Что вы сделаете с нейтральным результатом: запишете вывод или забудете про эксперимент? Если хотя бы на один вопрос ответа нет, тест почти наверняка закончится слайдом в отчёте, решения за ним не будет.
Главное правило здесь организационное, новый инструмент аналитики его не заменит: тест не запускают, пока в карточке нет вопроса и заранее описанного решения для каждого исхода. Статистика и платформа важны, но без этой формулы они только аккуратнее считают эксперименты, которые ничего не меняют. Одно это правило отсекает большую часть экспериментов, которые никогда не должны были начаться.