Карта влияния умещается на одном листе: цель, люди, поведение, работа. Трудность в другом. Метод требует вслух объяснить, как каждая задача из бэклога сдвинет цель. На этом вопросе многие планы рассыпаются.
Impact Mapping знают все, а применяют единицы
Про Impact Mapping слышал почти каждый продакт. По назначению его используют редко. Для одних это ещё одна диаграмма, для других модное слово из Agile-среды. В итоге инструмент либо игнорируют, либо рисуют для галочки.
А решает он одну из самых болезненных проблем команд: разрыв между стратегической целью и повседневными задачами. Карта отвечает на вопрос, почему именно эти действия должны привести к результату. Вопрос «что делаем дальше» решают уже после неё.
Куда девается смысл по дороге от цели к бэклогу
Цели формулирует руководство. В команды они спускаются списком инициатив. По дороге смысл теряется: задачи есть, а какие изменения должны произойти, никто не знает.
Формально всё логично (есть KPI, есть roadmap, есть бэклог). На практике фичи попадают в план, потому что «кажется важным», «просит клиент» или «так делают конкуренты». Impact Mapping возник как реакция на это. Он отделяет действия, способные сдвинуть цель, от активности без понятного эффекта.
Похожий разрыв хорошо виден на OKR. Когда у одной цели десять ключевых результатов, это уже склад задач: каждый отдел дописал свой пункт, и никто не решился вычеркнуть чужой. С картой то же самое: десять равноправных целей в центре означают, что выбор просто отложили.
Метод выбирает направление, сроки считают другие инструменты
Impact Mapping рисует путь от цели к задачам через поведение людей. Логика простая: цель достигается, когда конкретные люди начинают действовать иначе.
Границы у метода чёткие. Он не заменяет бэклог, roadmap или план спринта. Он не скажет, когда работа будет готова и сколько она стоит. Карта остаётся рабочей гипотезой, и её пересматривают по мере появления данных.
У метода есть близкий родственник из практики непрерывного исследования клиентов, дерево возможностей: результат, возможности, решения, эксперименты. Логика у них общая. Решение появляется только после того, как названо, что должно измениться у человека.
Кому он нужен по-настоящему
Сильнее всего карта помогает, когда никто не знает точно, какие фичи двинут метрику. Продакту становится проще говорить с руководством и заказчиками. Вместо спора о приоритетах начинается разговор о целях и ожидаемом эффекте, и в команде меньше политики.
Разработчикам карта объясняет, зачем они делают задачу. Инженер, который знает, какое поведение пользователя команда хочет изменить, лучше решает технические вопросы. Дизайнер тоже.
Но не всем. Команде из трёх человек с одним очевидным клиентом карта почти не нужна: все и так знают, чьё поведение меняют. Метод окупается, когда групп людей, на которых вы влияете, больше трёх или когда больше двух руководителей тянут в разные стороны.
Четыре уровня карты, и задачи всегда последние
В центре стоит цель. Дальше акторы (люди, чьё поведение важно), затем импакты (что они должны начать делать иначе), и только потом deliverables, то есть конкретные задачи. Порядок неслучаен: команда сначала решает, какое поведение изменить, и лишь потом ищет, чем это сделать.
Цель конкретна и измерима. Она описывает результат. Способ появится ниже, на уровне задач. Хорошая цель отвечает, что изменится в бизнесе при успехе. Плохая звучит как перечень действий или абстрактное «улучшить». И цель должна быть одна: карта плохо переносит попытку охватить всё сразу. Ориентиры можно взять из опроса Ленни Рачицки о North Star в 40 с лишним компаниях: у Airbnb это забронированные ночи, у Amplitude еженедельно обучающиеся пользователи.
Акторы шире ролей в системе. Это все, кто принимает решения и действует: пользователи, клиенты, партнёры, поддержка, отдел продаж. Этот шаг часто расширяет картину. Вдруг выясняется, что удержание зависит от того, как быстро поддержка отвечает новичкам.
Импакт описывает, что человек начнёт делать иначе. Здесь легко сбиться на решения. «Добавить кнопку» импактом не считается. «Новый пользователь создаёт второй проект в первую неделю» считается. Переход от фич к поведению даётся тяжело, и импакт почти всегда остаётся гипотезой.
Шаблон карты на одной странице
Шаблон для первой сессии. Цифры в примере придуманы для SaaS-сервиса средней руки:
- Цель. Одна метрика, базовое значение, целевое значение, срок. Пример: доля пользователей, вернувшихся через 30 дней, с 22% до 28% к концу квартала.
- Акторы. Три-пять групп с размером. Пример: новые пользователи (4 000 в месяц), администраторы аккаунтов (600), поддержка (6 человек).
- Импакты. На каждого актора одно-три изменения поведения, каждое с метрикой. Пример: новый пользователь завершает ключевой сценарий в первые 3 дня (сейчас 35%).
- Deliverables. На каждый импакт одна-две задачи и способ проверки. Пример: короткий онбординг из трёх шагов, проверка через A/B-тест на новых пользователях.
- Проверка. Для каждой ветки: какой результат через 6 недель будет означать, что гипотеза неверна.
Пятая строка самая важная. Ветка без условия опровержения не проверяется, а значит, её нельзя и закрыть.
Как сравнить ветки карты
Карта сама не расставляет приоритеты, но даёт для них материал. Удобная грубая оценка: ожидаемый вклад ветки = размер группы актора x ожидаемое изменение поведения x доля этого поведения, переходящая в цель.
Возьмём цифры из шаблона. Новых пользователей 4 000 в месяц. Если онбординг поднимет долю завершивших ключевой сценарий с 35% до 45%, это 400 человек. Если из них возвращаются через 30 дней 60%, ветка даёт около 240 удержанных в месяц. Ветка про администраторов: 600 человек, рост приглашений коллег на 10 пунктов, это 60 администраторов. Если каждое приглашение приводит двух удерживаемых пользователей, выходит 120.
Первая ветка вдвое сильнее, и спорить о ней проще: цифры на столе. В бытовых единицах это 8 удержанных человек в день против 4. Все три множителя здесь гипотезы, и это нормально. Ценность расчёта в том, что видно, какой множитель проверять первым.
Где метод ломается
Чаще всего в самом начале. Обсуждение стартует с фич, а цель формулируют слишком широко. Потом сбоит середина: людей путают с должностями, а изменения поведения описывают как решения.
Экономить на сессии бессмысленно. Шесть человек на два часа стоят 12 человеко-часов. Одна фича, сделанная не для той цели, стоит двух инженеров на спринт, около 160 часов. Сессия окупается, если отсекает хотя бы одну такую фичу в квартал.
Тревожные сигналы
Следить удобнее по четырём признакам:
- разговор на сессии всё время съезжает к задачам и с трудом возвращается к цели;
- в графе импактов стоят глаголы «добавить», «сделать», «внедрить», и команда ищет один правильный импакт вместо набора гипотез;
- карту рисует и правит один человек, без коллективного разбора;
- после первой сессии к ней не возвращаются, и данные её не меняют.
Любой из этих сигналов превращает карту в декорацию.
Карта задним числом
Самое частое злоупотребление: карту рисуют под готовый список фич, чтобы оправдать уже принятые решения. Выдаёт её одна деталь. Все deliverables идеально привязаны, а ни одна ветка не осталась пустой. Живая карта всегда содержит импакты, под которые пока нечего делать.
Встречаются и импакты вроде «улучшить UX» или «повысить удобство». Они не говорят, что человек будет делать иначе, и ничего не помогают решить. Это как вписать в рецепт «приготовить вкусно».
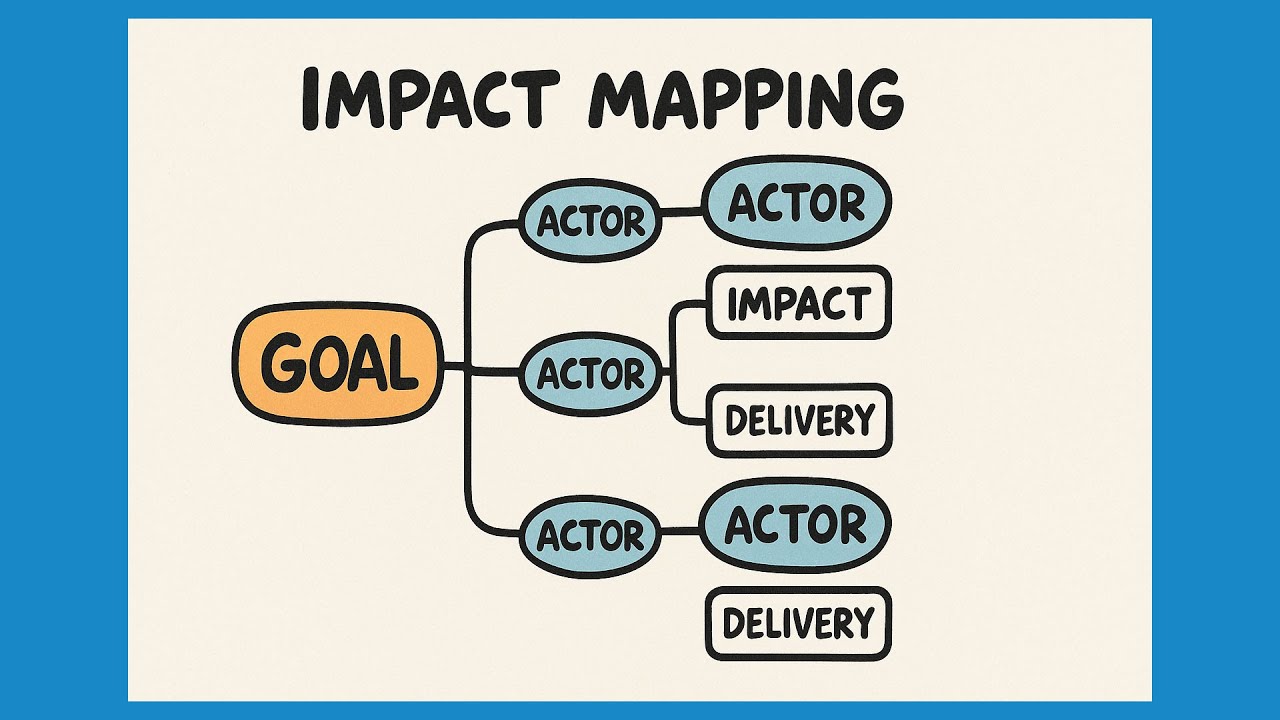
Как карта меняет разговор в типичной команде
От хаотичных инициатив к фокусу
Представим продуктовую команду SaaS-сервиса, которая регулярно запускала новые функции. У каждой было логичное обоснование, но ключевая метрика удержания стояла на месте, а команда чувствовала перегрузку. Такую картину видел, наверное, каждый продакт.
На сессии сформулировали одну цель: больше пользователей, вернувшихся через месяц. Это сразу отсекло часть инициатив. Разбор акторов показал, что сильнее всего на метрику влияют те, кто не завершил ключевой сценарий в первые дни. Внимание сместилось с привлечения на активацию. Импакт звучал так: пользователь быстрее понимает ценность продукта. Команда пересмотрела онбординг вместо новых функций, часть задач отменила, часть отложила.
Оценивать результат стоит по удержанию похожих групп пользователей: тех, кто пришёл до изменений и после. И проверить, что ещё менялось в тот же период.
Договор с бизнесом
Второй сюжет тоже знаком многим: карту завели из-за постоянных конфликтов с руководителями со стороны бизнеса. Руководители приносили инициативы, которые считали критичными. Общей логики между ними команда не видела. Roadmap переписывался каждый квартал, и доверие к планированию таяло.
На первой совместной сессии фичи отложили и начали с одной бизнес-цели. Сразу возникло напряжение: единого понимания цели не оказалось. После согласования перешли к акторам, и часть «очевидных» инициатив не привязалась ни к одному импакту. Это стало аргументом убрать их. Roadmap стал короче и логичнее. Разногласия не исчезли, но переехали с уровня личных предпочтений на уровень целей. Через два квартала такие сессии стали регулярными.
Сколько гипотез на карте окажутся верными?
Меньше, чем хочется. Косвенный ориентир есть у Pendo: в отчёте о внедрении функций за 2019 год компания разобрала 615 подписок своих клиентов и насчитала 80% функций, которыми пользуются редко или никогда. Это данные вендора, который продаёт аналитику использования, так что к точной цифре стоит относиться осторожно. Порядок величин всё равно отрезвляет: большая часть сделанного не меняет поведение, ради которого её делали. Если на карте десять веток, разумно ждать, что подтвердятся две, от силы три.
Отсюда практическое правило. Пусть проверка одной ветки занимает две недели. Тогда все десять займут 20 недель, около полутора кварталов. Поэтому одновременно проверяют две-три ветки с наибольшим ожидаемым вкладом, а остальные держат в очереди.
Сами deliverables удобно считать экспериментами. Вместо «сделать фичу» команда проверяет, изменится ли поведение. Страх ошибки снижается, обучение ускоряется.
Отсюда и главная польза карты. Она не угадывает, какая ветка выстрелит, зато делает каждое предположение явным и проверяемым, а значит, неудачную ветку можно закрыть за две недели вместо квартала.
Как понять, что карта работает
Шесть вопросов, на каждый ответ «да» или «нет»:
- Есть ли одна измеримая цель с базовым значением и сроком?
- Названы ли реальные акторы, а не абстрактные роли?
- Описаны ли импакты как поведение, с метрикой у каждого?
- Привязан ли каждый deliverable к импакту и условию опровержения?
- Возвращалась ли команда к карте за последние 90 дней?
- Отказались ли вы благодаря карте хотя бы от одной инициативы?
Три «нет» и больше означают, что карта стала декорацией.
Что отвечать скептикам
Метод работает и вне продуктовой разработки: в маркетинге, внутренних трансформациях, обучении. Везде, где есть цель и люди, чьё поведение должно измениться. Язык карты адаптируют, логика остаётся.
Импакты формулировать трудно, потому что команды привыкли думать готовыми решениями. Без разговоров с пользователями на этом шаге легко растеряться. Навык приходит, когда команда спокойно признаёт, что многого пока не знает. Хорошо помогает вопрос о работе, ради которой человек вообще берётся за продукт: чего он пытается добиться в своей ситуации и что ему сейчас мешает?
Обновлять карту стоит при смене цели, после крупных экспериментов и примерно раз в квартал. Карта старше полугода без правок почти наверняка описывает прошлую стратегию.
Импакт нельзя превращать в премиальный KPI. Как только за «второй проект в первую неделю» начнут платить, команда научится создавать пустые проекты, и метрика вырастет ровно тогда, когда перестанет что-либо значить.
Руководители сопротивляются чаще всего из-за формата: ждали разговора о решениях, а получили разговор о поведении людей. Помогают короткие сессии на 90 минут и одна конкретная цель. Навязывать карту не нужно. Убеждает первая инициатива, от которой отказались по делу.
Самый полезный результат первой сессии выглядит как список инициатив, которые не привязались ни к одному импакту: это и есть работа ради работы.